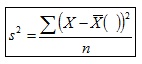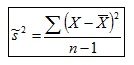martes, 12 de mayo de 2020

4.4.1. Establecimiento de la precisión

Sea H un intervalo cualquiera definido sobre la recta real. Definiremos ahora una variable ficticia, XH , de la siguiente forma:


De manera que cada observación de Xt Ileva asociada una observación -con valor o ó 1- de la variable XNr . La función de densidad teórica -desconocida- de Xt asigna una probabilidad pH
al intervalo H. Esto significa que:


Producir T replicaciones del vector y, implica disponer de una muestra de T “observaciones" de la variable real X. Esta muestra lleva asociada, a su vez, una muestra de tamaño T de la variable Xy .Esta variable sigue una distribución binaria de parámetro pH , así que la suma de las T observaciones de XH , ZH = XH^ +. ,.+ X y T , sigue una distribución binomial b(pH ,^. Es oportuno aquí hacer una adaptación al presente contexto del concepto de estimación precisa de Finster{ 1987) Definición 1. ,ZH /T es una estimación precisa de pN con nivel de imprecisión A y confianza 1-a (can 0< cx < 1), si


EI conjunta de precisión [-A, A] es el conjunto de errores de simulación aceptables. En lo que sigue a continuación se intentará determinar cuál es el número de replicaciones mínimo para obtener una estimación de pH can nivel de imprecisión fijo A y confianza 1-a. EI teorema de Moivre (ver por ejemplo Fz. de Trocóniz 1993) prueba que la sucesión b(pH ,1), b(pH ,2),.
..,b(pH , 7^, es asintóticamente normal N{T pH ,T p^ [1- pH ]) de manera que si T pH > 1 S se suele tomar como válida la siguiente aproximación a la distribución de ZH :


Establecimiento de la precisión del formulario y otras opciones

Para establecer la precisión y otras opciones:
  1. Consulte Acerca de la configuración de precisión.
  2. Abra el formulario y, a continuación, haga clic en Otras opciones.
  3. En Precisión, especifique el número de posiciones decimales visibles en una celda para Valores de moneda, Valores no de moneda y Valores porcentuales.
    Especifique los valores oportunos en Mínimo para agregar ceros a los números con pocos decimales. Especifique los valores oportunos en Máximo para truncar y redondear la parte decimal de los números grandes. Por ejemplo:
    Tabla 18-21 Ejemplos de precisión de datos
    ValorPrecisión mínimaPrecisión máximaValor mostrado
    100
    0
    Cualquiera
    100
    100
    3
    Cualquier número mayor que o igual a 3 o Ninguno.
    100,000
    100,12345
    Cualquier número menor que o igual a 5.
    Ninguno
    100,12345
    100,12345
    7
    Ninguno
    100,1234500
    100,12345
    Cualquier número menor que o igual a 3.
    3
    100,123
    100,12345
    0
    0
    100
    100,12345
    2
    4
    100,1235
    100
    2
    4
    100,00
    4. Para asociar los menús al formulario, muévalos de Menús disponibles a Menús seleccionados. Para varios menús, haga clic en una de las opciones de "mover" situadas a la derecha para especificar el orden de visualización 
  4.  Seleccione Activar variables de usuario dinámicas para permitir variables de usuario dinámicas en el formulario (consulte Trabajar con Planning).

lunes, 11 de mayo de 2020

4.3 muestras preliminares de los proyectos aprobados en

En la adecuada selección de una muestra aleatoria simple, uno de los aspectos contemplados se refiere al tamaño mínimo requerido para garantizar unos niveles de confiabilidad y precisión, establecidos de antemano, en las estimaciones. En el proceso de estimación de la media poblacional, con la media muestral como estimador, es necesario el conocimiento previo del valor de la varianza, σ^2 .Si este no se tiene, se toma una muestra preliminar cuyo objetivo es obtener una estimación de σ^2. En este trabajo se presenta una metodología adecuada para estimar este tamaño de muestra preliminar para el caso de poblaciones cuyas distribuciones pueden ser aproximadas a una distribución uniforme o triangular. La metodología puede aplicarse a muchas otras situaciones.
Keywords (es_ES)
Muestra Aleatoria Simple; Muestra Preliminar; Distribuciones Uniforme; Triangular y Gamma; Simulación de Monte Carlo

4.4 características estadísticas del estimador líder

 Sesgo. Se dice que un estimador es insesgado si la Media de la distribución del estimador es igual al parámetro.
Estimadores insesgados son la Media muestral (estimador de la Media de la población) y la Varianza (estimador de la Varianza de la población):
Ejemplo
En una población de 500 puntuaciones cuya Media (m) es igual a 5.09 han hecho un muestreo aleatorio (número de muestras= 10000, tamaño de las muestras= 100) y hallan que la Media de las Medias muestrales es igual a 5.09, (la media poblacional y la media de las medias muestrales coinciden). En cambio, la Mediana de la población es igual a 5 y la Media de las Medianas es igual a 5.1 esto es, hay diferencia ya que la Mediana es un estimador sesgado.
La Varianza es un estimador sesgado. Ejemplo: La Media de las Varianzas obtenidas con la Varianza
en un muestreo de 1000 muestras (n=25) en que la Varianza de la población es igual a 9.56 ha resultado igual a 9.12, esto es, no coinciden. En cambio, al utilizar la Cuasivarianza
 bu
la Media de las Varianzas muestrales es igual a 9.5, esto es, coincide con la Varianza de la población ya que la Cuasivarianza es un estimador insesgado.

2) Consistencia. Un estimador es consistente si aproxima el valor del parámetro cuanto mayor es n (tamaño de la muestra).
Algunos estimadores consistentes son:
Ejemplo
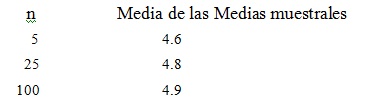
En una población de 500 puntuaciones cuya Media (m) es igual a 4.9 han hecho tres muestreos aleatorios (número de muestras= 100) con los siguientes resultados:
vemos que el muestreo en que n=100 la Media de las Medias muestrales toma el mismo valor que la Media de la población.

3) Eficiencia. Diremos que un estimador es más eficiente que otro si la Varianza de la distribución muestral del estimador es menor a la del otro estimador. Cuanto menor es la eficiencia, menor es la confianza de que el estadístico obtenido en la muestra aproxime al parámetro poblacional


4.2. Identificación del estimador determinante (estimador líder) del tamaño de la simulación

1) Sesgo. Se dice que un estimador es insesgado si la Media de la distribución del estimador es igual al parámetro.
Estimadores insesgados son la Media muestral (estimador de la Media de la población) y la Varianza (estimador de la Varianza de la población):
Ejemplo
En una población de 500 puntuaciones cuya Media (m) es igual a 5.09 han hecho un muestreo aleatorio (número de muestras= 10000, tamaño de las muestras= 100) y hallan que la Media de las Medias muestrales es igual a 5.09, (la media poblacional y la media de las medias muestrales coinciden). En cambio, la Mediana de la población es igual a 5 y la Media de las Medianas es igual a 5.1 esto es, hay diferencia ya que la Mediana es un estimador sesgado.
La Varianza es un estimador sesgado. Ejemplo: La Media de las Varianzas obtenidas con la Varianza
en un muestreo de 1000 muestras (n=25) en que la Varianza de la población es igual a 9.56 ha resultado igual a 9.12, esto es, no coinciden. En cambio, al utilizar la Cuasivarianza
la Media de las Varianzas muestrales es igual a 9.5, esto es, coincide con la Varianza de la población ya que la Cuasivarianza es un estimador insesgado.

2) Consistencia. Un estimador es consistente si aproxima el valor del parámetro cuanto mayor es n (tamaño de la muestra).
Algunos estimadores consistentes son:
Ejemplo
En una población de 500 puntuaciones cuya Media (m) es igual a 4.9 han hecho tres muestreos aleatorios (número de muestras= 100) con los siguientes resultados:
vemos que el muestreo en que n=100 la Media de las Medias muestrales toma el mismo valor que la Media de la población.

3) Eficiencia. Diremos que un estimador es más eficiente que otro si la Varianza de la distribución muestral del estimador es menor a la del otro estimador. Cuanto menor es la eficiencia, menor es la confianza de que el estadístico obtenido en la muestra aproxime al parámetro poblacional.


4.1.2. Medios de registro de datos

La elección del método depende de la estrategia de recopilación de datos, el tipo de variable, la
precisión necesaria, el punto de recopilación y la formación del encuestador. Las vínculos entre
una variable, su origen y los métodos prácticos para su recopilación. Pueden ayudar a escoger
métodos apropiados. Los principales métodos de recopilación de datos son:
 Registros: los registros y licencias son particularmente valiosos para los censos
completos, pero se limitan a variables que cambian lentamente, como el número de
embarcaciones pesqueras y sus características.
 Cuestionarios: formularios que los encuestados devuelven cumplimentados. Un método
poco costoso que resulta útil cuando los índices de alfabetización son altos y los
encuestados colaboran.

4.1.1. Instrumentos de medición

El análisis de la literatura existente arroja un resultado de 17 instrumentos de medida de las
actitudes y la ansiedad hacia la estadística. Exceptuando dos instrumentos elaborados a partir
de escalas bipolares, a la manera del diferencial semántico de Osgood (Birenbaum y Eylath,
1994; Green, 1993), todos los instrumentos revisados son escalas tipo Likert. En lo que sigue
vamos a describir brevemente estos cuestionarios, poniendo un mayor énfasis en aquellos que
han sido usados más frecuentemente

4.1 Lista de estimadores a obtener de la simulación

Definiremos algunas propriedades de los estimadores.
1) Parámetro. Verdadero valor de una caracterı́stica de interes, denominado por θ, que
raramente es conocido.
2) Estimativa. Valor numérico obtenido por el estimador, denominado de θ̂ en una
m uestra.
3) Viés y no viés. Un estimador es no in-sesgado si: E(θ̂) = θ, onde el viés es dado por:
vies(θ̂) = E(θ ˆ θ) = E(θ̂) − θ
Cuadrado médio del error (ECM). Es dado por:
ECM (θ̂) = E(θ̂ − θ)2 = V (θ̂) + (vies
1) Un estimador es consistente si: plim(θ̂) = θ ; y lim −→ ∞ECM (θ̂) = 0
2) Las leyes de los grandes números explican por qué el promedio o media de una muestra
al azar de una población de gran tamaño tenderá a estar cerca de la media de la
población completa.